
はじめに
こんな経験はありませんか——
混雑した電車の中で、携帯電話に向かって三回叫んでも"「もしもし、聞こえますか」"、相手からは"「そちらがうるさすぎます」”
と返される。在宅会議では、キーボードの音、エアコンの音、ペットの鳴き声が交錯し、同僚から"「そちらの電波状態が悪いのですか」"
と尋ねられる。サイクリングしながら録画Vlogする際、風切り音が周囲の他の環境音を飲み込み、本来のサイクリングの思い出から音色の彩りが失われてしまう。
モバイルインターネットとAIoTの時代において、"「はっきり聞こえる」"ことは音声対話の最低限の要件となっている。しかし、現実世界の音響環境は実験室よりもはるかに複雑である。——電車の轟音、オフィスのキーボード音、車内の路盤騒音、屋外の風切り音が、常に音声通信の品質を脅かしている。
本稿では、ユーザーシナリオ、コアニーズ、業界の課題、解決策という 4 つの次元から、オーディオノイズリダクション技術の進化ロジックと打開策を解説する。
1. ノイズは至る所に存在:4 つのシナリオ、4 つの"「聞き取りにくい」"
オーディオノイズリダクションの応用シナリオは生活の隅々にまで浸透しており、大きく分けて 4 つのカテゴリーに分類できる。
モバイル通信シナリオは最も基礎的な需要の陣地である。
ユーザーが電車、街中、商業施設などの環境で携帯電話通話やビデオチャットを行う際、背景ノイズはしばしば70-85dBに達し、音声信号を直接掩蔽してしまい、相手が頻繁に"「もしもし、聞こえますか」"と尋ねる原因となる。
リモートワークシナリオは近年爆発的に成長した。
在宅環境のノイズは非定常成分が主体である。——キーボードの打鍵音(瞬態、2-5msの持続時間)、エアコンの低周波轟音(定常、<500Hz)、家族との会話(方向性干渉)。これらのノイズは時間 - 周波数領域において音声と高度に重複しており、単一のアルゴリズムでは両立させることが困難である。さらに、多数の参加者がいるシナリオでは、ノイズリダクションアルゴリズムが全二重通信をサポートすることが求められ、近端で話している同時に、スピーカーから漏洩するエコーと環境ノイズをリアルタイムで抑制しなければならず、これはアルゴリズムの因果性(causality)に対して厳格な要求を突きつける。

図 1 時間 - 周波数領域:音声とノイズの特徴比較
車載シナリオは典型的な高ノイズの戦場である。
車速が80km/hのとき、車内ノイズは75dB以上に達し、エンジン、タイヤ、風切り音が重なり合ううえ、車内での複数人の音声干渉も加わり、車載通話や音声アシスタントにとって極めて大きな課題となる。

図 2 極端な SN 比シナリオ:車載通話
スマートウェアラブルおよびスマートホームシナリオでは、ノイズリダクションに対してより高い要求が課せられる。
TWSイヤホンはノイズキャンセリングモードと透過モードの間をシームレスに切り替える必要がある。スマートスピーカーは3-5メートルの遠距離条件下で、テレビの音声や会話声の中から起動ワードを抽出しなければならない。屋外用録音・録画機器は風切り音を抑制し、対象となるオーディオ信号の明瞭度を向上させる必要がある。

図 3 サイクリングシナリオ:風速ノイズの干渉
これらのシナリオに共通するのは、ユーザーがもはや"「聞こえればよい」"という状態に満足せず、"「はっきり聞こえ、自然に聞こえ、快適に聞こえる」"ことを求めている点である。

図 4 応用シナリオ別のノイズタイプ
二、良いノイズキャンセレーションとは、単に"音を小さくすることだけではない"
上記のシナリオ围绕し、オーディオノイズキャンセレーションの核心的なニーズは 4 つのレベルに集約できます:

図 5 核心的なニーズの 4 次元
第一に、音声の明瞭度を最優先すること。
通話や音声対話シナリオにおける首要的な目標は、相手が一字一句を理解できるように確保することであり、単にノイズをどれだけ抑え込むかを追求することではありません。過度なノイズキャンセレーションにより音声がこもったり、言葉が欠落したりすると、むしろコミュニケーション効率が低下します。
客観的評価においては、STOI(Short-Time Objective Intelligibility)で明瞭度を予測し、PESQ/PLCMOS音質の自然度を評価します。主観的評価ではITU-T P.835基準に従い、それぞれSIG(信号歪み)、BAK(背景ノイズ干渉)、OVRL(全体品質)に対して5点制で採点を行います。ハイエンド会議システムではOVRL≥3.5が要求され、補聴器シナリオではSIGに対する許容度がさらに低く、≥4.0が要求されます。
第二に、リアルタイム性と低遅延。
リアルタイム通話では通常、アルゴリズムの遅延が20ms未満であることが要求され、ライブ配信のイヤーモニターに至っては10ms未満が要求されます。これは、アルゴリズムが極めて短いオーディオフレーム内で分析と処理を完了しなければならず、複雑度の高いオフラインモデルを使用できないことを意味します。フレーム長とフレームシフトがアルゴリズムの遅延を直接決定します:20msフレーム長+10msフレームシフトは音声処理の一般的な構成ですが、少なくとも20msのアルゴリズム遅延をもたらします。これにAECの20-40msおよびコーデックの20msが加わると、総遅延は簡単にITU-T G.114が推奨する150msの上限を超えてしまいます。
したがって、低遅延ノイズキャンセレーションでは10msのフレーム長、50%のオーバーラップという積極的な構成を採用することが多く、その代償として周波数分解能が低下し(わずか400個の周波数点@48kHz)、高調波の回復が困難になります。
第三に、音質の自然度。
ビデオ会議やライブ配信シナリオでは、音声の自然度に対して極めて高い要求があります。ノイズキャンセレーション後の音声に"金属音"、"管を通したような音"、あるいは顕著なスペクトルホールが発生してはならず、元の音声の音色や感情を保持する必要があります。
第四に、計算量と消費電力のバランス。
TWSイヤホンやスマートウォッチなどのデバイスはバッテリー容量が限られているため、ノイズキャンセレーションアルゴリズムは効果と消費電力の間で最適なバランスを見つけなければならず、ノイズキャンセレーションのためにバッテリー持続時間を犠牲にしてはなりません。100ms遅延@48kHz/16bitモノラルでは4800個のサンプル点が必要であり、循環バッファは約9.6KBを占有します。32bit浮動小数点深層学習モデルを採用する場合、パラメータ量は数百KBレベルまで圧縮する必要があり、INT8量子化、重み共有、または知識蒸留。awinic 帝江®オーディオソリューションを例にすると、音声アシスタントのフロントエンドノイズキャンセレーションに必要な計算量はわずか60MCPS、通話シーンでは約200MCPS、ROM+RAM合計で1MB未満であり、これによりTWSなどの小型デバイス上で長時間動作させることが可能になります。
三、理想は豊かだが、現実は厳しい:ノイズキャンセレーションにおける 5 つの主要な課題
需要は明確であるものの、エンジニアリング実装においては多くの厄介な痛みに直面しています:
定常ノイズと非定常ノイズとの駆け引き。
従来のスペクトル減算法やWienerフィルタリングは、エアコンやファンなどの定常ノイズに対してはある程度効果的ですが、キーボード音、ドアをノックする音、食器がぶつかる音などの非定常ノイズに対しては往往にして無力です。这类のノイズは時間領域の特徴が顕著で、周波数スペクトルの変化が速く、従来の統計モデルでは追従することが困難です。
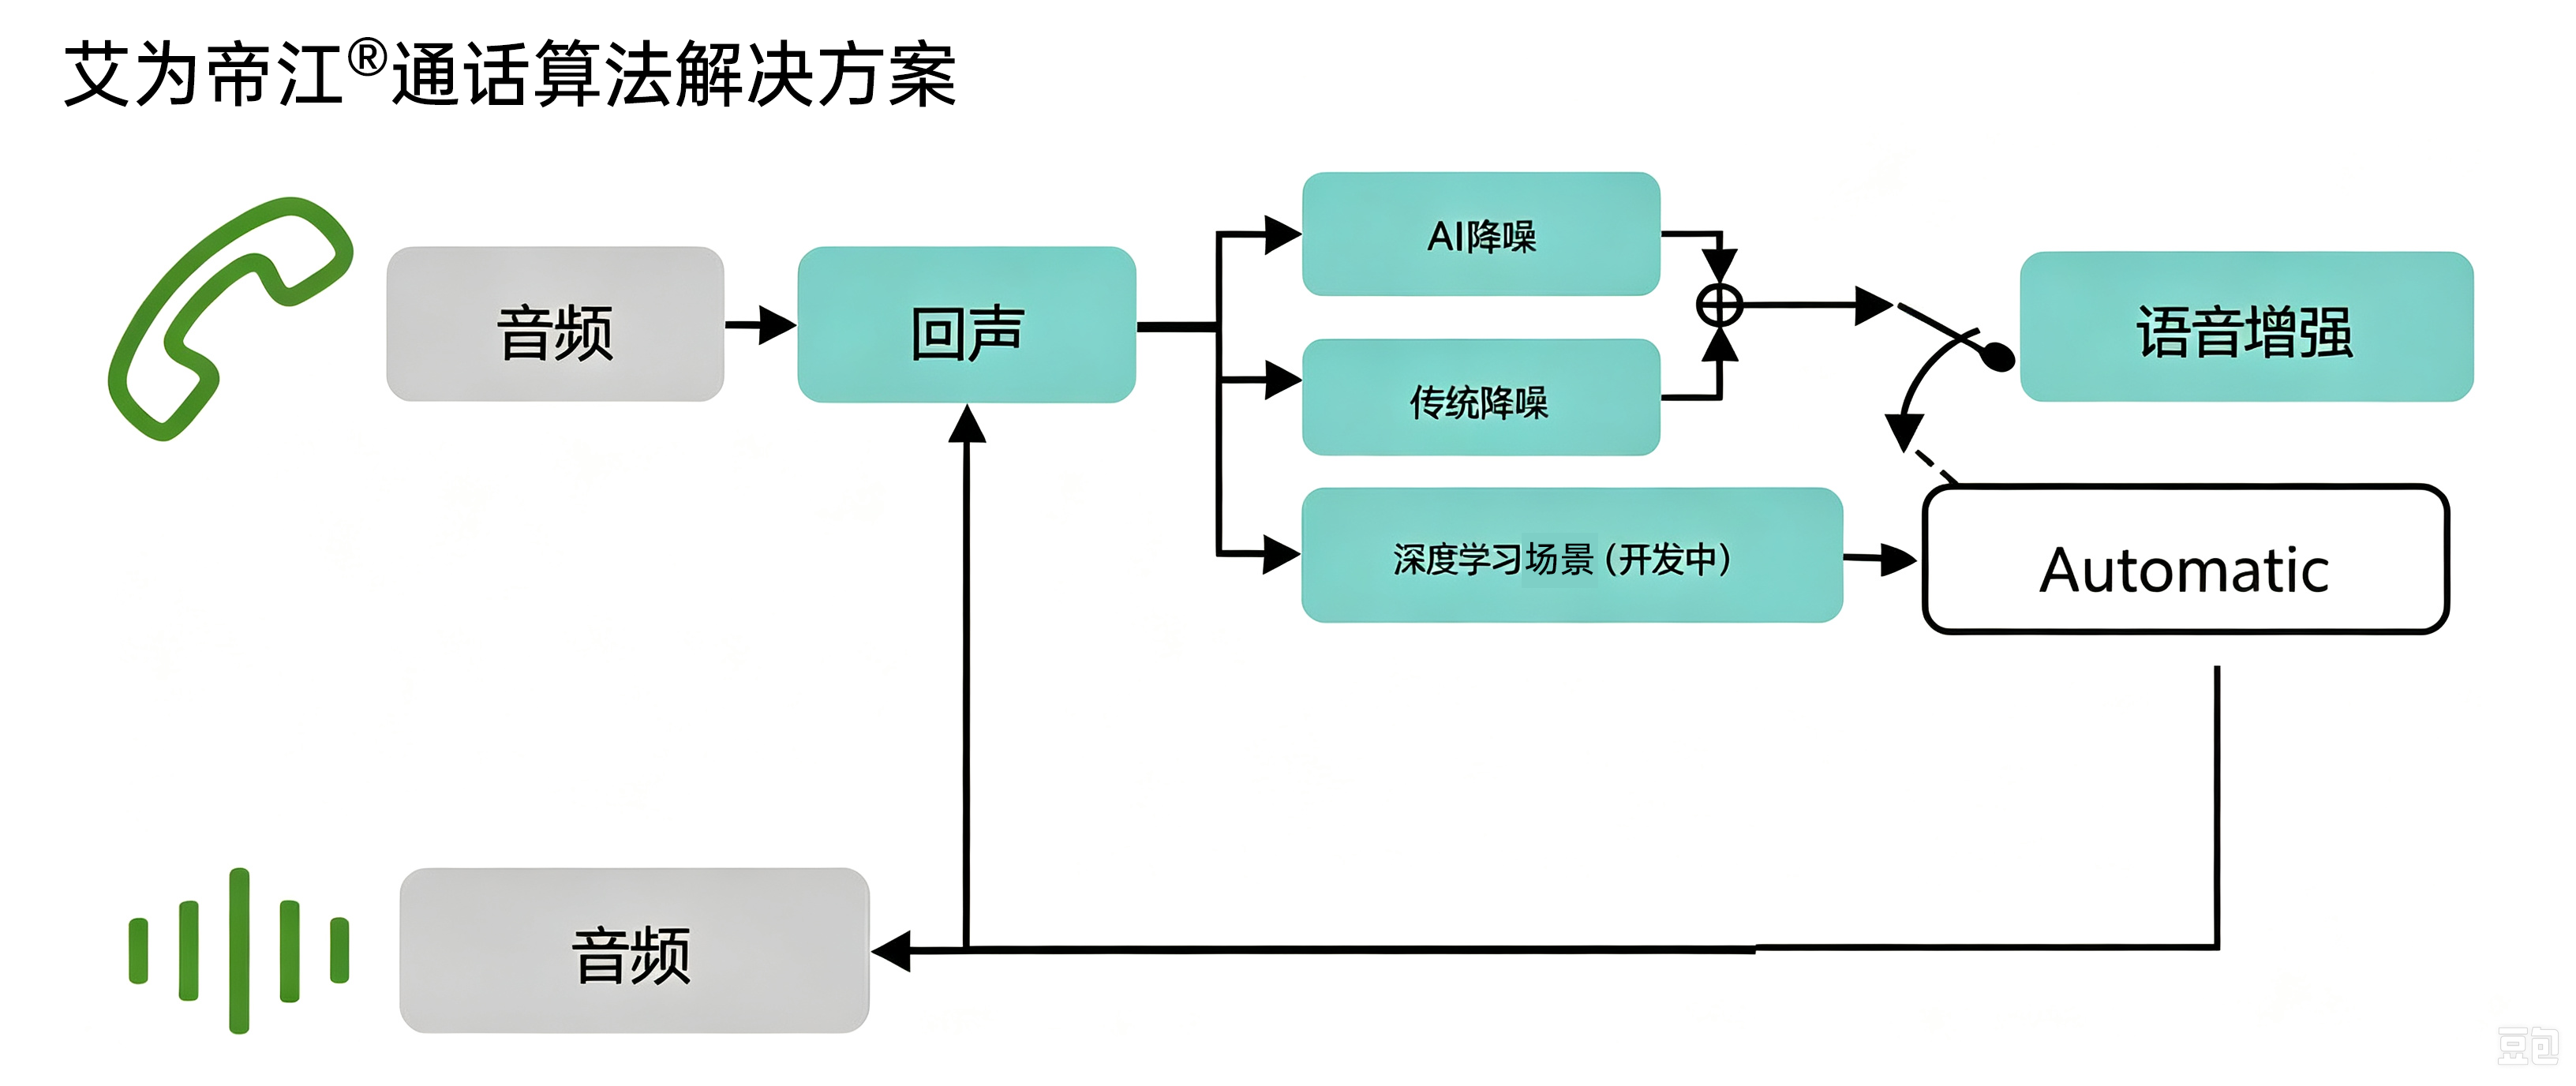
図 6 awinic 通話シーン用ノイズキャンセレーションソリューション
風切りノイズ処理の難題。
風がマイクに当たることで発生する低周波エネルギーは極めて高く、かつ音声帯域と严重に重なっています。従来のアルゴリズムでは、風切りノイズを音声と誤判定したり、過度に抑制して音声を严重に歪ませたりしやすいです。屋外シーンでは、風切りノイズが通話体験の最低ラインを直接決定します。風切りノイズは声波ではなく、乱流がマイクの振動板に及ぼすランダムな圧力擾乱であり、そのスペクトルエネルギーは低周波(<1kHz)に集中しており、音声の基本周波数と高度に重なっています。フォワードマイクの振動板は風圧を直接受け、严重的な低周波飽和を引き起こします;防風スポンジを追加しても、物理的な減衰には限界があります。
アルゴリズムレベルでは、風切りノイズ検出は通常、ゼロ交差率(ZCR)と低周波エネルギー比率の結合判断に依存しますが、高風速下(>5m/s)では、風切りノイズの電力が音声の10dB以上となり、従来のVAD+ゲイン制御戦略は無効化し、複数のマイクの位相差または骨伝導補助に基づく信頼性の高い音声検出が必要となります。この分野において、awinic は競争力のあるソリューションを提供しています。
awinic 帝江®のAI風切りノイズ低減アルゴリズムを例にとると、ソリューション全体の主観的スコアは約 33%向上しました;異なる風速シーンにおいても安定した優位性を示します:4m/s シーンでは約 27%向上、5-7m/s 屋外シーンでは約 35%向上、13m/s 強風の極端シーンでは約 43%向上しました。客観的テストではP.835規格を参照し、SIG指標は早歩き、ジョギング、オートバイなどのシーンにおいていずれも顕著な向上を示しました。
ノイズキャンセレーションと音声損傷の矛盾。
ノイズキャンセレーションの本質は"減算"——であり、ノイズを含む信号から推定されたノイズを差し引くことです。減算が不十分だとノイズが残存し明显になります;減算しすぎると、音声の詳細まで一緒に削除され、"音楽的ノイズ"(musical noise)やスペクトルの空洞が発生します。この両者の間でいかにバランスを取るかが、アルゴリズムチューニングの核心的な難点です。

図 8 ノイズキャンセレーションと音声損傷のバランス
多様なシーン切り替えへの適応困境。
ユーザーが静かなオフィスから騒がしい通りへ、さらに高速走行中の車内へと移動すると、音響環境は瞬く間に変化します。固定パラメータのノイズキャンセレーションソリューションではこのような動的変化に適応できず、一方、適応型アルゴリズムは収束速度と安定性の間のトレードオフに直面します。
ハードウェア計算能力の天井。
ハイエンドDSPでは複雑な深層学習モデルを実行できますが、ミドルローエンドチップやTWSイヤホンの計算能力は極めて限られています。計算能力の制約下で、ハイエンドデバイスに近いノイズキャンセレーション効果をいかに実現するかが、量産導入における鍵となるボトルネックです。

図 9 計算能力-メモリ-消費電力:不可能な三角関係
四、突破口:単独行動から"単独行動"へ"共進化"
上記の課題に対し、オーディオノイズキャンセレーション技術は"単独行動"から"共進化"へのパラダイムシフトを経験しています:
従来アルゴリズムと深層学習の融合。
純粋な深層学習モデル(例:RNNoise、DeepFilterNet)は非定常ノイズの抑制に優れていますが、計算リソースの消費が大きいものです。エンジニアリングの実践では、しばしば"従来型+AI"のハイブリッドアーキテクチャが採用されます:従来アルゴリズムが定常ノイズを迅速に収束させて処理し、深層学習モデルが非定常ノイズおよび瞬時ノイズの精密な抑制を担当します。両者は相互補完的であり、効果と効率の両立を図ります。この融合アーキテクチャは、量産ソリューションにおいてすでに検証されています。awinic 帝江®まさにこのアプローチの典型代表です——__TRANS_0170__9億台を超えるデバイスへの導入実績に基づき、伝統的な信号処理の迅速な収束と20モデルの精密な抑制を深く統合し、ウェアラブルデバイスの限られた計算能力の下で優れたノイズキャンセレーション効果を実現しています。AIマルチマイクアレイとビームフォーミング。
シングルマイクのノイズキャンセレーションは周波数領域情報のみを利用できますが、デュアルマイクまたはマルチマイクアレイは空間次元を導入することができます。ビームフォーミング(
)技術により、集音ビームを目標話者方向に向けると同時に、他の方向からのノイズを抑制します。これは車載、会議用スピーカー、スマートスピーカーなどのシーンでは標準装備となっています。ウェアラブルデバイスにおいては、Beamforming量子化(重みと活性化値)、構造化プルーニング(重要でないチャネルの削除)、および知識蒸留(大規模モデルによる小規模モデルの指導)を採用する必要があります。INT8さらに、マイクアレイの空間情報を利用することで、シングルチャネルノイズキャンセレーションとビームフォーミング(
)をカスケード接続できます:ビームフォーミングがMVDR/GSCの指向性ゲインを提供し、後続のシングルチャネルアルゴリズムの難易度を下げ、より軽量なネットワークの使用を可能にします。awinic 帝江6-12dBは®チャンネルのマルチマイクアレイをサポートし、ビームフォーミングを通じて個人音声ゾーンの集音を実現します。心形、超指向性など多様なビーム形状と組み合わせることで、帯域外干渉信号を効果的に抑制し、翻訳や通話などのシーンで目標音声の SN 比を大幅に向上させます。2-8マルチセンサーフュージョンと状況認識。8ハイエンドソリューションでは、骨伝導マイクまたは加速度計を音声活動の信頼性の高い参照として導入します
骨伝導信号は空気伝搬ノイズの影響を受けず、頭蓋骨の振動によって伝達される音声のみを集音します。骨伝導と気伝導の相互相関分析により、高信頼度の
を構築し、ノイズキャンセレーションゲインの適用タイミングを指導できます。拾音距離に特殊な要件がある翻訳などのシーンでは、複数気伝導マイク plus——(音声収集ユニット)を組み合わせた近遠場収集ソリューションが既に実用化されており、VADデュアル差動マイクアレイによって近遠場の音源を区別し、近場VPU遠場抑制アルゴリズムと連携することで、独立した音声ゾーンの収集を実現しています。DM-BF同時に、軽量級の/ベースのシーン分類器(静寂
街中CNN車内/強風)に基づいてノイズキャンセレーション戦略をリアルタイムで切り替えます:強風シーンでは風切音専用フィルタを起動し、車内シーンでは低周波抑制を強化し、真の適応化を実現します。/まとめ/オーディオノイズキャンセレーション技術の究極の目標は、環境を完全な静寂にすることではなく、雑騒の中で明確なコミュニケーションを守ることにあります。スペクトル減算法から深層学習へ、シングルマイクからアレイへ、固定パラメータから適応型インテリジェンスへ。技術の每一次の進化は、理想的な体験と現実環境との距離を縮めています。
今後
年間のアップストリームオーディオアルゴリズムは、継続的に
化、マルチモーダル、全シーン対応の方向へと進化していくでしょう:2-3__TRANS_0199__AI年以上にわたるアルゴリズムの自社開発の蓄積と、累計2026年将落地通用AIノイズキャンセリング、特定のシナリオAIノイズキャンセリング(屋内/屋外/オフィス/地下鉄駅)、指向性ビーム(超指向性、8字、心形、近遠場ビーム)、音源定位、AIエコーキャンセル、オーディオズーム、音声ウェイクアップ(VAD+KWS)など;2027年には、マルチモーダルノイズ抑制(ボタン操作、ジェスチャー)、声紋認証(声紋活動検出+声紋ノイズリダクション)、大規模モデルASRサードパーティ連携などの革新的アプリケーションをさらに推進します。軽量なシーン分類ネットワークを通じて、現在"静かな屋内"、"街中"、"車内"それとも"強風環境"かどうかをリアルタイムで判断し、対応するノイズキャンセリング戦略とパラメータ設定を自動的に切り替え、真の全シーン適応を実現します。
同時に、awinic はハードウェアレベルでのフルリンク布局——オーディオPA(1W~300Wパワードライバ)、Codec/ADC/DAC(高 S/N 比>112dB、高サンプリングレート低遅延<100uS)、オーディオバス(100Mbps車載Soundwire)、ADSP/NPUが、チップからアルゴリズムに至るまでの完全なシステムレベルソリューションをアルゴリズムの実装に提供しています。


沪ICP备10011954号 |

沪公网安备 31011202011955号
