
서문
이런 경험을 해본 적이 있나요——
붐비는 지하철 안에서 휴대폰을 향해 세 번이나 외쳤는데"여보세요, 들리나요"라고 했지만 상대방은 여전히"거기 너무 시끄러워요”
라고 말합니다. 재택 회의 중에는 키보드 소리, 에어컨 소리, 반려동물 울음소리가 뒤섞여 동료가"那边 신호가 안 좋은가요"
라고 묻습니다. 자전거를 타며 녹음할Vlog때는呼呼 부는 바람 소리가 주변 다른 환경음을 덮어버려 원래의 자전거 라이딩 추억에 소리의 채색을 잃게 만듭니다.
모바일 인터넷과AIoT시대에서"잘 들리는 것"은 이미 음성 상호작용의 최소 요구사항이 되었습니다. 그러나 실제 세계의 음향 환경은 실험실보다 훨씬 복잡합니다.——지하철의 굉음, 사무실의 키보드 소리, 차内の 도로 소음, 야외의 바람 소음이 항상 음성 통신의 품질을 위협하고 있습니다.
오늘 우리는 사용자 시나리오, 핵심 요구사항, 업계 페인포인트 및 해결책이라는 네 가지 차원에서 오디오 노이즈 캔슬링 기술의 진화 논리와 돌파구를 분석해 보겠습니다.
1. 소음은无处不在: 네 가지 시나리오, 네 가지"잘 안 들림"
오디오 노이즈 캔슬링의 적용 시나리오는 생활의 모든 구석구석에 침투해 있으며 대략 네 가지 범주로 나눌 수 있습니다:
모바일 통신 시나리오는 가장 기본적인 수요의 영역입니다.
사용자는 지하철, 거리, 쇼핑몰 등의 환경에서 휴대폰 통화나 영상 채팅을 하는데 배경 소음이 종종70-85dB에 달해 음성 신호를 직접 가려 상대방이 자주"여보세요, 들리나요"라고 묻게 됩니다.
원격 근무 시나리오는 최근 몇 년 사이 폭발적으로 성장했습니다.
재택 환경의 소음은 비정상성 성분이 주를 이룹니다.——키보드 타자음 (순간적,2-5ms지속 시간), 에어컨의 저주파 굉음 (정상성,<500Hz), 가족과의 대화 (방향성 간섭). 이러한 소음들은 시간 - 주파수 영역에서 음성과高度로 겹쳐 단일 알고리즘으로는 모두 대응하기 어렵습니다. 또한 다수 참가자 시나리오에서는 노이즈 캔슬링 알고리즘이 전이중 통신을 지원해야 하며, 즉 근단에서 말하는 동시에 스피커에서 새어 나오는 에코와 환경 소음을 실시간으로 억제해야 하므로 알고리즘의 인과성 (causality) 에 대해 엄격한 요구사항이 제기됩니다.

그림 1 시간 - 주파수 영역: 음성과 소음 특징 비교
차량용 시나리오는 전형적인 고소음 전장입니다.
车速가80km/h일 때 차내 소음은75dB이상에 달하며 엔진, 타이어 및 풍절음이 중첩되고 차내 다수의 음성 간섭까지 더해져 차량용 통화 및 음성 비서에极大的인 도전을 제기합니다.

그림 2 극단적인 신호대잡음비 시나리오: 차량용 통화
스마트 웨어러블 및 홈 시나리오는 노이즈 캔슬링에 대해 더 높은 요구사항을 제시합니다.
TWS이어폰은 노이즈 캔슬링 모드와 투명 모드 사이를 원활하게 전환해야 하며; 스마트 스피커는3-5미터의 원거리에서도 TV 소리나 대화 소리 중에서 웨이크업 워드를 추출해야 합니다; 야외 녹음/녹화 장비는 풍절음을 억제하여 목표 오디오 신호의 선명도를 높여야 합니다.

그림 3 자전거 라이딩 시나리오: 풍속 소음 간섭
이러한 시나리오들의 공통점은 사용자가 더 이상"들리기만 하면 됨"에 만족하지 않고"잘 들리고, 자연스럽게 들리며, 편안하게 들리는 것"을 요구한다는 점입니다.

그림 4 적용 시나리오별 소음 유형
둘째, 좋은 노이즈 캔슬링은 단순히"소리를 작게 만드는 것이 아닙니다"
위의 시나리오를 중심으로 오디오 노이즈 캔슬링의 핵심 요구사항은 네 가지 차원으로 요약할 수 있습니다:

그림 5 핵심 요구사항 4 차원
첫째, 음성 명료도 우선입니다.
통화 및 음성 상호작용 시나리오에서 가장 중요한 목표는 상대방이 모든 단어를 명확히 이해하도록 보장하는 것이며, 단순히 노음을 얼마나 낮추느냐를 추구하는 것이 아닙니다. 과도한 노이즈 캔슬링으로 인해 음성이 답답해지거나 단어가 누락되면 오히려 소통 효율이 떨어집니다.
객관적 평가에서는STOI(Short-Time Objective Intelligibility) 예측 명료도를,PESQ/PLCMOS음질 자연도를 평가하며; 주관적 평가는ITU-T P.835표준을 따르고, 각각SIG(신호 왜곡),BAK(배경 노음 간섭),OVRL(전체 품질) 에 대해5점수제로 평가합니다. 하이엔드 회의 시스템은OVRL≥3.5를 요구하며, 보청기 시나리오에서는SIG에 대한 허용 범위가 더 낮아≥4.0를 요구합니다.
둘째, 실시간성과 저지연입니다.
실시간 통화는 일반적으로 알고리즘 지연이20ms미만이어야 하며, 라이브 스트리밍 모니터링은 심지어10ms미만이어야 합니다. 이는 알고리즘이 매우 짧은 오디오 프레임 내에서 분석과 처리를 완료해야 함을 의미하며, 고복잡도의 오프라인 모델을 사용할 수 없습니다. 프레임 길이와 프레임 이동은 알고리즘 지연을 직접 결정합니다:20ms프레임 길이+10ms프레임 이동은 음성 처리의 일반적인 구성이지만 최소20ms의 알고리즘 지연을 유발합니다. 여기에AEC의20-40ms와 코덱의20ms가 겹치면 총 지연이 쉽게ITU-T G.114에서 제안하는150ms상한선을 초과합니다.
따라서 저지연 노이즈 캔슬링은 종종10ms프레임 길이,50%오버랩이라는 공격적인 구성을 채택하며, 그 대가로 주파수 분해능이 감소합니다 (단400개 주파수 빈@48kHz). 이로 인해 고조파 복원의 난이도가 증가합니다.
셋째, 음질 자연도입니다.
화상 회의 및 라이브 스트리밍 시나리오에서는 음성 자연도에 대한 요구가 매우 높습니다. 노이즈 캔슬링 후의 음성은"금속음","관악기 소리"또는 뚜렷한 스펙트럼 공백이 나타나서는 안 되며, 원본 음성의 음색과 감정을 유지해야 합니다.
넷째, 연산량과 전력 소비의 균형입니다.
TWS이어폰, 스마트워치 등의 기기는 배터리 용량이 제한적이므로, 노이즈 캔슬링 알고리즘은 효과와 전력 소비 사이에서 최적의 균형점을 찾아야 하며, 노이즈 캔슬링을 위해 배터리 지속 시간을 희생해서는 안 됩니다.100ms지연@48kHz/16bit모노 채널에는4800개의 샘플 포인트가 필요하며, 순환 버퍼는 약9.6KB를 차지합니다; 만약32bit부동소수점 딥러닝 모델을採用한다면, 파라미터 수를 수백KB수준으로 압축해야 하며, 반드시INT8양자화, 가중치 공유 또는 지식 증류. awinic DiJiang®오디오 솔루션을 예로 들면, 음성 어시스턴트 프론트엔드 노이즈 캔슬링에 필요한 연산량은 단지60MCPS이며, 통화 시나리오에서는 약200MCPS,ROM+RAM합계1MB미만이어야만TWS과 같은 소형 장치에서 장시간 실행할 수 있습니다.
3. 이상은 풍부하지만 현실은 냉혹함: 노이즈 캔슬링의 5 대 난제
요구사항은 명확하지만, 엔지니어링 구현 과정에서 다음과 같은 많은 까다로운 문제점에 직면합니다:
정상 상태 소음과 비정상 상태 소음 간의 경쟁.
전통적인 스펙트럼 감산법,Wiener필터링은 에어컨, 팬 등 정상 상태 소음에는 효과가 있지만, 키보드 소리, 문 두드리는 소리, 식기 부딪히는 소리와 같은 비정상 상태 소음에는 속수무책인 경우가 많습니다. 이러한 소음은 시간 영역 특성이 뚜렷하고 주파수 스펙트럼 변화가 빠르기 때문에 전통적인 통계 모델로 추적하기 어렵습니다.
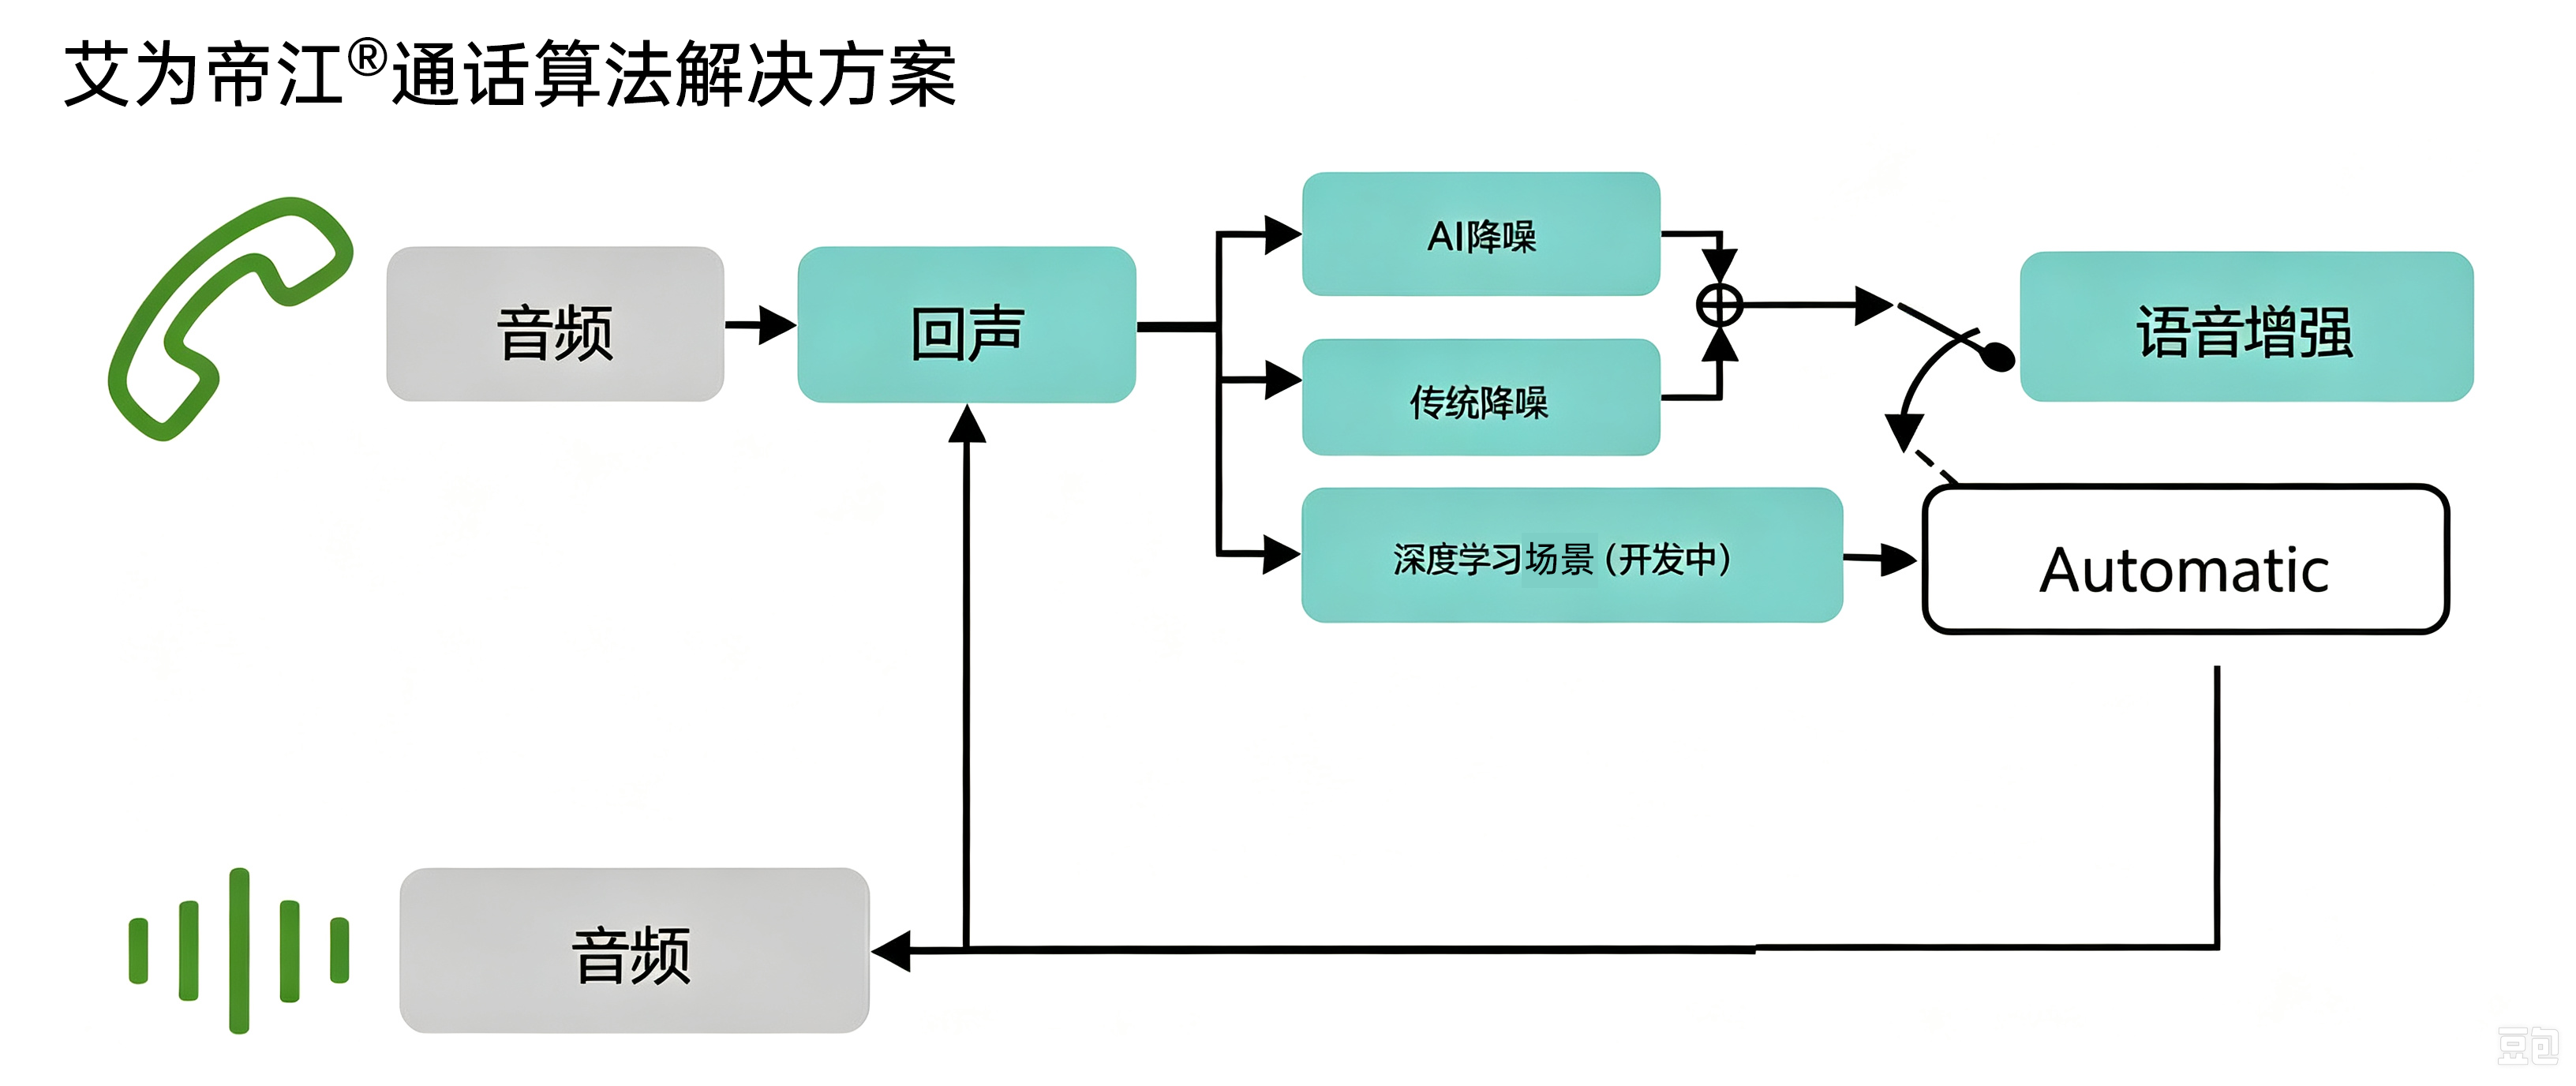
그림 6 awinic 통화 시나리오 노이즈 캔슬링 솔루션
풍절음 처리의 난제.
바람이 마이크에 불어 발생할 때 저주파 에너지가 극도로 높으며 음성 대역과 심각하게 겹칩니다. 전통적인 알고리즘은 풍절음을 음성으로 오인하거나 과도하게 억제하여 음성이 심각하게 왜곡되는 경우가 많습니다. 야외 시나리오에서 풍절음은 통화 경험의 하한선을 직접 결정합니다. 풍절음은 음파가 아니라 난류가 마이크 진동막에 가하는 무작위 압력 섭동이며, 그 스펙트럼 에너지는 저주파 (<1kHz) 에 집중되어 있고 음성 기본 주파수와 고도로 겹칩니다. 피드포워드 마이크의 진동막은 풍압을 직접 받아 심각한 저주파 포화를 일으키며, 방풍 스펀지를 추가하더라도 물리적 감쇠에는 한계가 있습니다.
알고리즘 측면에서 풍절음 감지는 일반적으로 영교차율 (ZCR) 과 저주파 에너지 비율의 결합 판정에 의존하지만, 강풍 조건 (>5m/s) 에서 풍절음 전력이 음성을10dB이상 초과하면 전통적인VAD+이득 제어 전략이 무효화되므로, 다중 마이크 위상차 또는 골전도 보조를 기반으로 한 신뢰할 수 있는 음성 감지가 필요합니다. 이 분야에서 awinic 은 이미 경쟁력 있는 솔루션을 내놓았습니다.
awinic DiJiang®의AI풍절음 감소 알고리즘을 예로 들면, 솔루션 전체의 주관적 점수가 약 33%향상되었습니다; 다양한 풍속 시나리오에서 안정적인 우위를 보입니다:4m/s 시나리오에서 약 27%향상,5-7m/s 야외 시나리오에서 약 35%향상,13m/s 강풍 극한 시나리오에서 약 43%향상. 객관적 테스트는P.835표준을 참조하며,SIG지표는 빠르게 걷기, 조깅, 오토바이 등 시나리오에서 모두 현저히 향상되었습니다.
노이즈 캔슬링과 음성 손상의 모순.
노이즈 캔슬링의 본질은"감산"——으로, 잡음이 포함된 신호에서 추정된 노이즈를 빼는 것입니다. 덜 빼면 노이즈 잔류가 뚜렷하고, 너무 많이 빼면 음성 디테일이 함께 제거되어"음악성 노이즈"(musical noise) 또는 스펙트럼 공백이 발생합니다. 이 둘 사이에서 균형을 찾는 것이 알고리즘 튜닝의 핵심 난점입니다.

그림 8 노이즈 캔슬링과 음성 손상의 균형
다중 시나리오 전환의 적응困境.
사용자가 조용한 사무실에서 시끄러운 거리로 이동하고 다시 고속 주행 중인 자동차로 들어갈 때 음향 환경은 순식간에 변합니다. 고정 파라미터 노이즈 캔슬링 솔루션은 이러한 동적 변화에 적응할 수 없으며, 적응형 알고리즘은 수렴 속도와 안정성 사이의 절충 문제에 직면합니다.
하드웨어 연산 능력의 한계.
하이엔드DSP는 복잡한 딥러닝 모델을 실행할 수 있지만, 중저가 칩과TWS이어폰의 연산 능력은 극도로 제한적입니다. 연산 능력 제약 하에서 하이엔드 장치에 근접한 노이즈 캔슬링 효과를如何实现하는 것이 대량 생산 및 현장 적용의 핵심 병목 현상입니다.

그림 9 연산 능력-메모리-전력 소모: 불가능한 삼각형
4. 돌파구: "개별 작전"에서"협력 진화"
로"개별 작전"에서"협력 진화"로의 패러다임 전환이 이루어지고 있습니다:
전통 알고리즘과 딥러닝의 융합.
순수 딥러닝 모델 (예: RNNoise, DeepFilterNet) 은 비정상 상태 소음 억제에서 우수한 성능을 보이지만 연산 자원 소모가 큽니다. 엔지니어링 실무에서는 주로 "전통+AI"하이브리드 아키텍처를 채택합니다: 전통 알고리즘은 정상 상태 소음을 빠르게 수렴시켜 처리하고, 딥러닝 모델은 비정상 상태 소음 및 순간 소음의 정밀 억제를 담당하여 상호 보완적으로 효과와 효율성을 모두 확보합니다. 이러한 융합 아키텍처는 이미 양산 솔루션에서 검증되었습니다. awinic 제강®은 바로 이러한 접근법의 대표적인 사례입니다——9년 이상의 알고리즘 자체 연구 개발 축적과 누적 20억 대 장비의 설치 검증을 바탕으로, 전통 신호 처리의 빠른 수렴과 AI모델의 정밀 억제를 깊이 결합하여 웨어러블 기기의 제한된 연산 능력 하에서도 뛰어난 노이즈 캔슬링 효과를 실현했습니다.
다중 마이크 어레이 및 빔포밍.
단일 마이크 노이즈 캔슬링은 주파수 영역 정보만 활용할 수 있지만, 듀얼 마이크或多중 마이크 어레이는 공간 차원을 도입할 수 있습니다. 빔포밍 (Beamforming) 기술을 통해 수신 빔을 목표 화자 방향으로 향하게 하고 동시에 다른 방향의 소음을 억제합니다. 이는 차량용, 회의용 기기, 스마트 스피커 등의 시나리오에서 이미 표준 구성이 되었습니다. 웨어러블 기기에서는 INT8양자화 (가중치 및 활성화 값), 구조적 가지치기 (불필요한 채널 제거), 그리고 지식 증류 (대규모 모델이 소규모 모델을 지도) 를 채택해야 합니다.
또한, 마이크 어레이의 공간 정보를 활용하여 단일 채널 노이즈 캔슬링과 빔포밍 (MVDR/GSC) 을 직렬로 연결할 수 있습니다: 빔포밍이 6-12dB지향성 이득을 제공하여 후속 단일 채널 알고리즘의 난이도를 낮추고, 더 경량화된 네트워크 사용을 가능하게 합니다. awinic 제강®2-8경로 다중 마이크 어레이를 지원하며, 빔포밍을 통해 개인 음역대 수음을 실현하고 8자형, 초지향성 등 다양한 빔 형태와 함께 작동하여 대역 외 간섭 신호를 효과적으로 억제함으로써 번역, 통화 등의 시나리오에서 목표 음성 신호 대비 잡음비 (SNR) 를 크게 향상시킵니다.
다중 센서 융합 및 상황 인지.
고급 솔루션은 골전도 마이크나 가속도계를 음성 활동의 신뢰할 수 있는 참조로 도입합니다——골전도 신호는 공기 전달 소음에 면역이며 두개골 진동을 통해 전달되는 음성만 수집합니다. 골전도와 기전도의 상호 상관 분석을 통해 높은 신뢰도의 VAD를 구축하여 노이즈 캔슬링 이득 적용 시기를 지도할 수 있습니다. 수음 거리에 특별한 요구 사항이 있는 번역 등의 시나리오에서는 다중 공기 마이크와 VPU(음성 수집 유닛) 을 결합한 근거리/원거리 수음 솔루션이 이미 구현되었으며, DM-BF이중 차분 마이크 어레이를 통해 근거리/원거리 음원을 구분하고 근거리 /원거리 억제 알고리즘과 연계하여 독립적인 음역대 수음을 실현합니다.
동시에, 경량 CNN기반 상황 분류기 (조용함/거리/차량 내부/강풍) 를 통해 노이즈 캔슬링 전략을 실시간으로 전환합니다: 강풍 시나리오에서는 풍절음 전용 필터를 활성화하고, 차량 내부 시나리오에서는 저주파 억제를 강화하여 진정한 적응형을 실현합니다.
맺음말
오디오 노이즈 캔슬링 기술의 궁극적인 목표는 환경을 고요하게 만드는 것이 아니라, 소음 속에서那份 선명한 소통을 지키는 것입니다. 스펙트럼 감산법에서 딥러닝으로, 단일 마이크에서 어레이로, 고정 파라미터에서 적응형 지능으로, 기술의每一次 진보는 이상적인 경험과 현실 환경 사이의 거리를 좁혀가고 있습니다.
미래 2-3년 동안 상행 오디오 알고리즘은 지속적으로 AI화, 멀티모달, 전場景 방향으로 진화할 것입니다:2026년에 일반 적용 예정AI노이즈 캔슬링, 특정 시나리오AI노이즈 캔슬링 (실내/실외/사무실/지하철역), 지향성 빔 (초지향성,8자형, 심형, 근거리/원거리 빔), 음원 위치 추정,AI에코 제거, 오디오 줌, 음성 웨이크업 (VAD+KWS) 등;2027년에는 멀티모달 노이즈 억제 (버튼 누르기, 손짓 제스처), 화자 인식 (화자 활동 감지+화자 기반 노이즈 감소), 대형 언어 모델ASR서드파티 연동 등 혁신적인 애플리케이션을 더욱 추진할 예정입니다. 경량화된 시나리오 분류 네트워크를 통해 현재"조용한 실내","거리","차량 내부"아니면"강풍 환경"인지 실시간으로 판단하여 해당 노이즈 캔슬링 전략과 파라미터 구성을 자동으로 전환함으로써 진정한 전 시나리오 적응형을 실현합니다.
동시에 awinic 은 하드웨어 수준의 엔드투엔드 레이아웃을 통해——오디오PA(1W~300W파워 드라이버),Codec/ADC/DAC(고 SNR>112dB, 고샘플링 저지연<100uS), 오디오 버스 (100Mbps차량용Soundwire),ADSP/NPU를 제공하여 알고리즘 구현을 위한 칩부터 알고리즘까지의 완전한 시스템 수준 솔루션을 마련했습니다.


沪ICP备10011954号 |

沪公网安备 31011202011955号
